중복 검색과 실패할 재시도를 줄여 AI 블로그 생성 비용을 낮췄다
춘천 운영 서버 로그로 글감 15건의 검색·본문 파싱 비용을 다시 계산했습니다. 실제 비용은 약 150원, 생략 호출을 되살린 비교값은 약 309원이었습니다.
목차
들어가며
NOTE
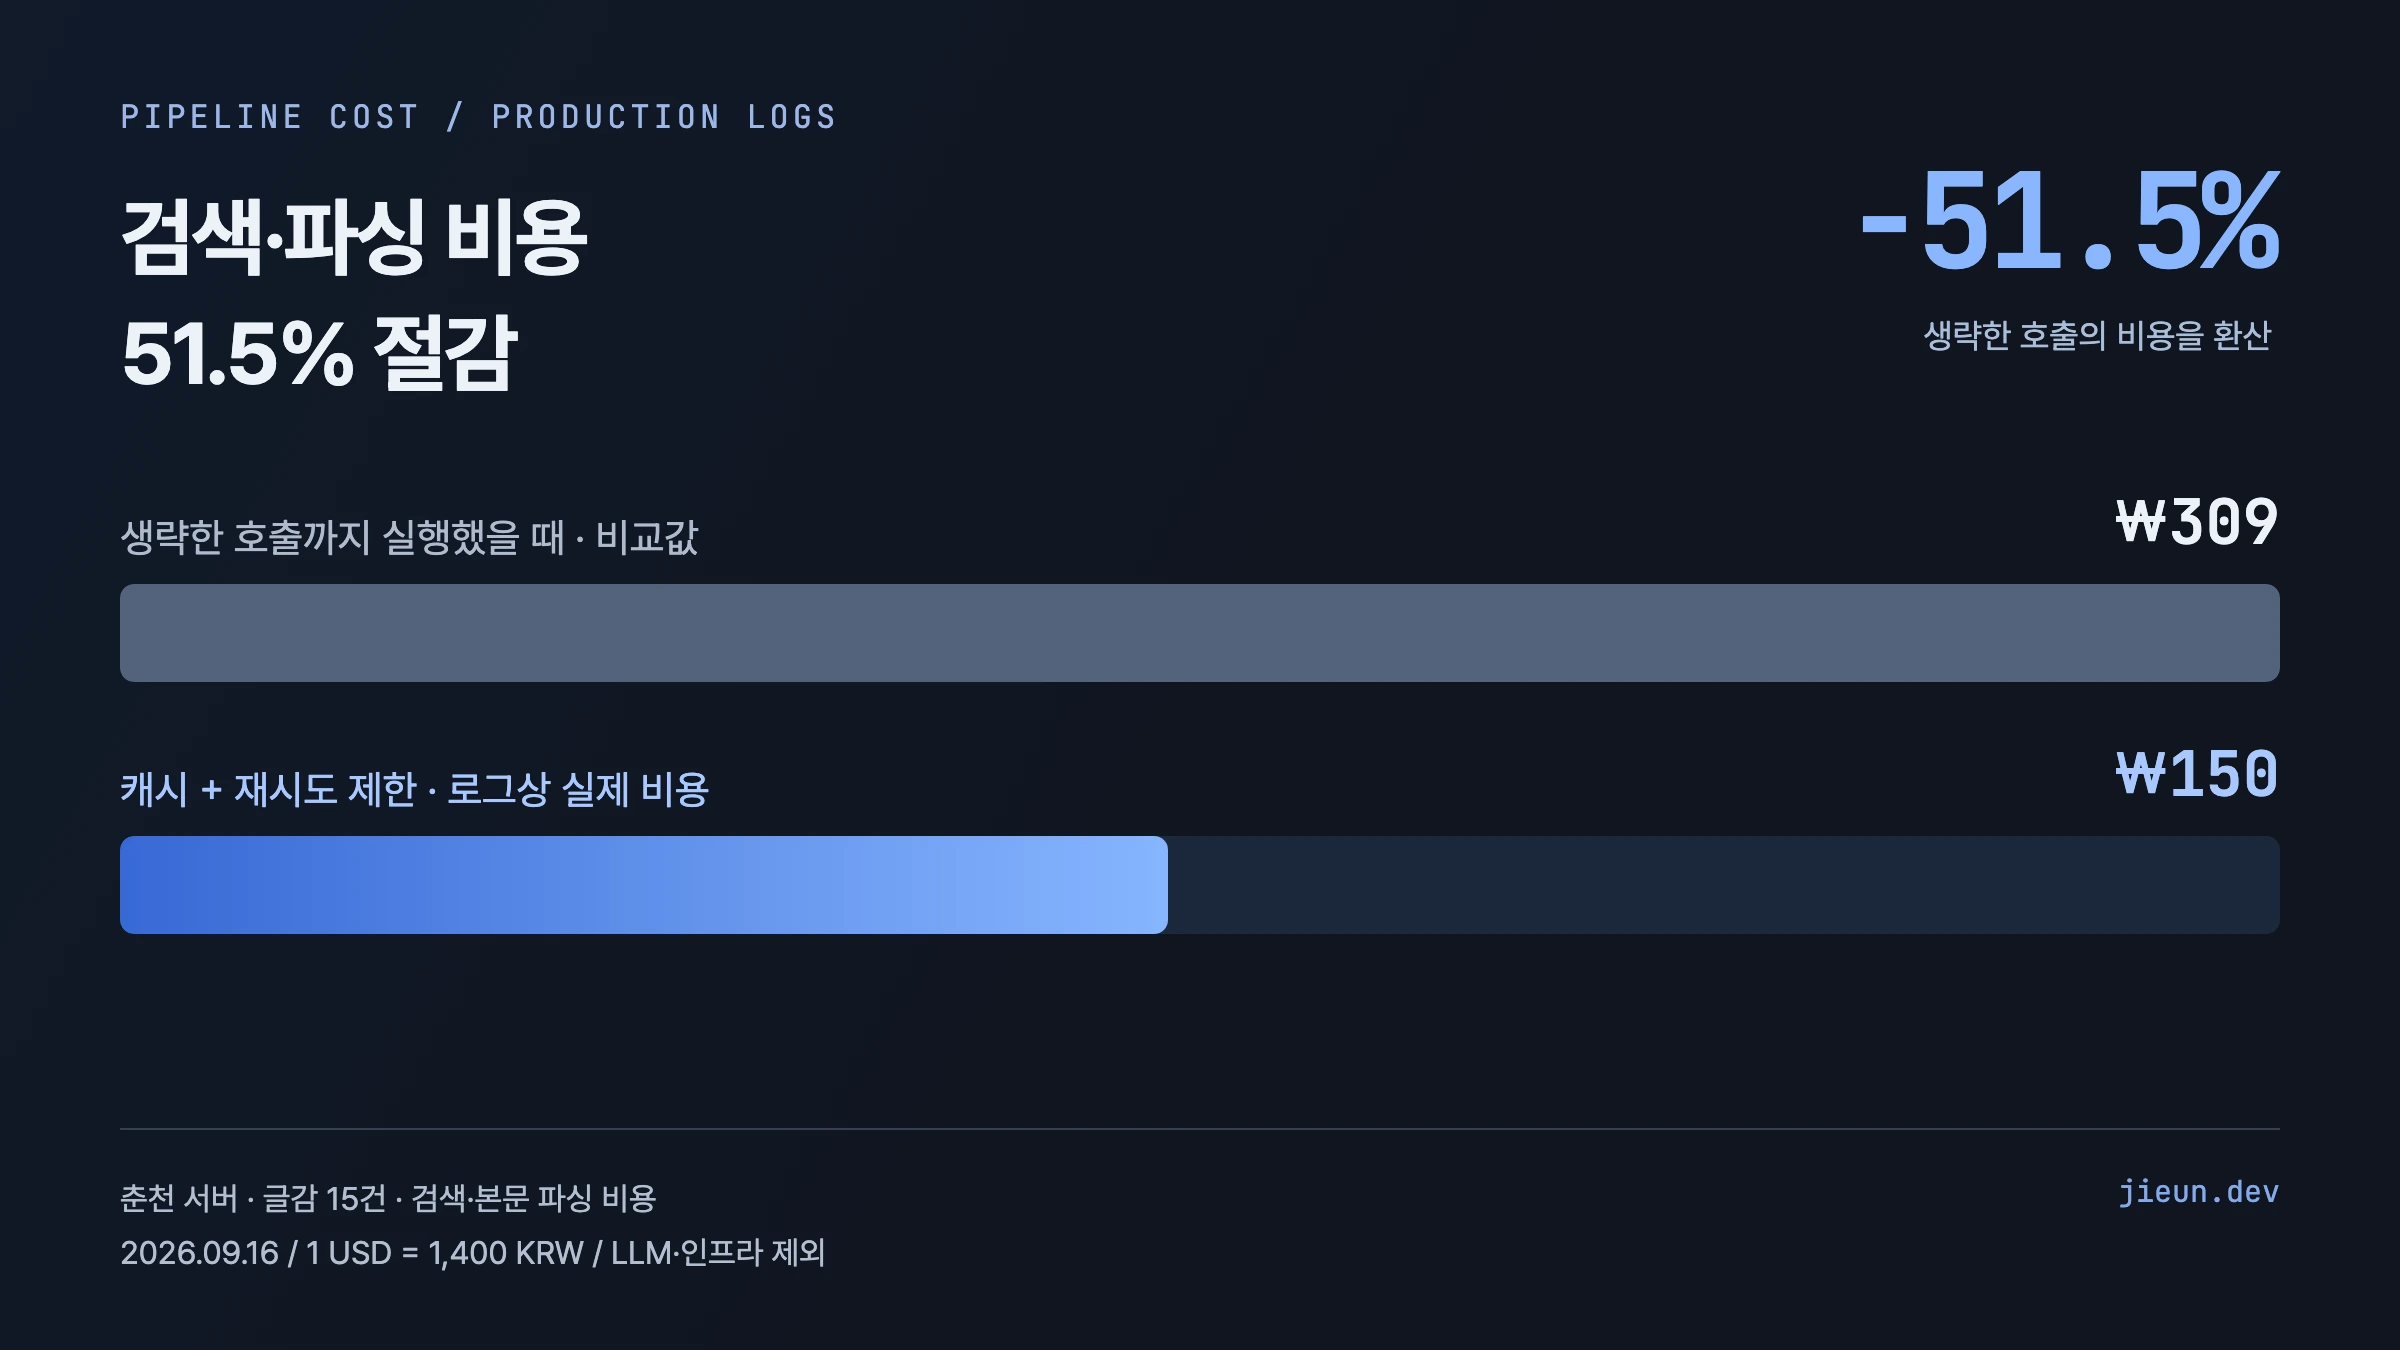
춘천 운영 서버의 글감 15건을 확인했습니다. 검색·본문 파싱에 실제로 쓴 비용은 약 150원입니다. 캐시와 재시도 제한으로 생략한 호출까지 실행했다면 약 309원으로, 환산 절감률은 51.5%입니다. 글감 하나당 약 20.6원에서 10.0원으로 내려간 계산입니다.
2026년 9월 16일 18:48–18:49 KST에 처리된 15건의 검색 비용 로그와 본문 파싱 로그를 연결했습니다. 실제 기록된 비용은 $0.1069였습니다.
생략한 호출은 두 종류였습니다.
| 항목 | 생략한 호출 | 호출 단가 | 환산 절감액 |
|---|---|---|---|
| 플랫폼 보충 검색 | 10회 | $0.010 | $0.1000 |
| JS 렌더링 재시도 | 9회 | $0.0015 | $0.0135 |
| 합계 | $0.1135 ≈ 159원 |
실제 비용 $0.1069에 생략한 호출의 비용 $0.1135를 더하면 비교 기준은 $0.2204입니다. 그중 생략한 비용이 51.5%입니다.
실제 비용과 생략 횟수는 로그 실측이고, 최적화가 없었을 때의 비용은 같은 호출 단가로 환산한 비교값입니다. 최적화 전후를 따로 실행한 대조 실험은 아닙니다. 환율은 달러당 1,400원으로 고정했으며, LLM 구독료와 인프라 비용은 제외했습니다.
제가 운영하는 블로그 생성 파이프라인은 키워드를 받아 글감 후보를 만들고, 후보마다 참고자료와 목차를 준비합니다. 사용자가 글감을 고르면 그 자료로 본문을 씁니다.
원가를 확인하려고 열어보니, 같은 검색 결과를 얻으려고 여러 번 결제하고 있었습니다. 사용자가 고르지 않을 글감에도 자료 수집 비용이 이미 나간 뒤였습니다.
비용 로그부터 추가하고, 중복 검색과 실패하는 재시도를 줄인 다음, 무제한이던 글감 생성에 상한을 뒀습니다. 이 글은 그 과정에서 무엇을 재봤고 어떤 판단을 바꿨는지에 대한 기록입니다.
1. 글 한 편의 원가를 모르고 있었습니다
처음에는 “글 한 편을 만드는 데 얼마가 드나”를 알고 싶었습니다. 그런데 비용은 발행 시점에만 생기지 않았습니다. 후보를 만드는 순간부터 이미 쌓이고 있었습니다.
선택하지 않은 후보도 이미 비용을 썼습니다
흐름은 이렇습니다.
키워드 입력 ↓글감 후보 여러 개 생성 ↓후보마다 검색·출처 수집·목차 작성 ↓사용자가 글감 선택 ↓선택된 글감의 자료를 재사용해 본문 생성문제는 세 번째 줄입니다. 사용자가 고르지 않은 후보도 검색과 본문 파싱을 이미 끝낸 상태입니다. 발행된 글 하나만 보면 싸 보이지만, 실제 원가는 선택되기 전까지 만든 모든 후보에 분산됩니다.
그래서 원가식도 바뀌었습니다.
발행 1건의 비용= 글감 후보 1건의 준비 비용 × 발행 1건당 만든 후보 수 + 본문 생성 비용로그부터 네 종류로 나눴습니다
처음에는 이걸 제대로 볼 수 없었습니다. 실패와 빈 결과와 필터링을 한데 묶어 “안 됐다” 정도로만 보고 있었기 때문입니다. 그래서 로그를 네 종류로 나눴습니다.
- 실행: 실제로 나간 호출
- 캐시: 저장된 결과로 채운 호출
- 빈 결과: 결과가 없어 비어 있던 슬롯
- 오류: 실패해서 다음 단계로 넘어가지 못한 호출
이 구분이 생기고 나서야 돈을 낸 작업과 돈을 내지 않고 지나간 작업을 분리해서 셀 수 있었습니다.
2. 같은 검색을 여러 번 결제하고 있었습니다
첫 번째 낭비는 보충 검색이었습니다. 글감 하나를 준비할 때는 일반 검색을 한 번 하고, 부족한 플랫폼 슬롯이 있으면 유튜브·나무위키·브런치 같은 플랫폼 검색을 추가로 돌립니다.
단가만 보면 일반 검색은 건당 $0.002이고, 플랫폼 보충 검색은 건당 $0.010입니다. 보충 검색 한 번이 일반 검색 다섯 번 값입니다. 후보가 늘어나면 이 차이가 바로 비용으로 튀어나옵니다.
캐시 키를 키워드와 플랫폼으로 잡았습니다
처음 구조에서는 플랫폼 검색 결과를 충분히 재사용하지 못했습니다. 같은 키워드와 같은 플랫폼 조합인데도, 후보가 달라지면 다시 검색을 살 수 있었습니다.
더 애매한 경우도 있었습니다. 일반 검색 결과 안에 이미 유튜브·브런치 같은 플랫폼 문서가 들어와 있었는데, 그 결과를 플랫폼 슬롯 캐시에 저장하지 않으면 뒤에서 같은 플랫폼 보충 검색을 다시 실행했습니다.
그래서 캐시 키를 키워드 + 플랫폼 슬롯으로 잡았습니다. 같은 키워드에서 유튜브 슬롯을 이미 채웠다면, 다음 후보는 그 결과를 먼저 가져다 씁니다.
일반 검색에서 발견한 플랫폼 문서도 같은 슬롯 캐시에 저장했습니다. 이미 산 일반 검색 결과에서 슬롯을 채울 수 있으면, 그 결과도 다음 후보가 재사용하게 만든 것입니다.
빈 결과와 오류를 구분해야 했습니다
검색을 해봤는데 쓸 만한 문서가 없었던 것과, API 오류 때문에 검색 자체가 실패한 것은 다릅니다.
- 빈 결과: 다시 해도 결과가 없을 가능성이 높으니 음수 캐시로 남깁니다.
- API 오류: 다음 시도에서 살아날 수 있으니 캐시하지 않습니다.
또 하나는 부분 적중입니다. 세 슬롯 중 두 슬롯은 캐시로 채웠지만 하나가 비면, 결국 보충 검색 호출은 나갑니다.
IMPORTANT
절감액으로 세려면 유료 호출이 실제로 생략됐는지를 봐야 합니다. 캐시를 두 개 읽었어도 보충 검색이 실행됐다면, 그 호출 비용은 그대로 나갑니다.
이 기준으로 보면 2026년 9월 16일 표본에서 플랫폼 보충 검색 10회가 생략됐습니다. 단가 $0.010을 곱하면 $0.1000입니다. 이 배치의 절감액 대부분이 여기서 나왔습니다.
3. 실패할 재시도와 버릴 글감에도 비용이 나갔습니다
두 번째 낭비는 본문 파싱의 JavaScript 재시도였습니다. 일반 본문 파싱은 건당 $0.00015입니다. 정적 파싱이 실패하면 JavaScript 렌더링으로 한 번 더 시도할 수 있는데, 이 재시도는 건당 $0.0015로 표준 파싱의 열 배입니다.
반복해서 실패한 호스트만 건너뜁니다
무작정 끄면 안 됩니다. 실제로 일부 사이트는 JS 렌더링으로 본문을 얻습니다. 8월 샘플에서도 JS 재시도 9건 중 4건은 성공했습니다.
성공 가능성이 확인된 재시도는 남겨두고, 실패 이력이 충분히 쌓인 호스트에서만 비싼 재시도를 생략했습니다.
호스트별로 재시도 결과를 쌓고, 다음 기준을 적용했습니다.
- 시도 횟수: 최소 3회 이상
- 실패율: 80% 이상이면 JS 재시도 생략
- 만료: 실패 이력은 30일 뒤 만료
사이트 구조는 바뀌고, 예전에 실패하던 페이지가 나중에는 성공할 수 있기 때문에 영구적으로 막지는 않았습니다.
여기서도 로그가 중요했습니다. 그냥 파싱 실패만 보면 품질 저하인지 비용 절감인지 알 수 없습니다. 그래서 skippedJsRetry를 따로 세고, 건너뛴 횟수에 $0.0015를 곱해 생략 비용을 계산했습니다.
2026년 9월 16일 표본에서는 JS 재시도 9회가 생략됐습니다. 환산 절감액은 $0.0135입니다. 검색 캐시만큼 크지는 않지만, 반복 실패 이력이 있는 호출을 다시 사지 않았다는 점은 로그로 확인됐습니다.
다만 이것만으로 본문 품질 전체가 보장됐다고 말할 수는 없습니다. 성공하는 JS 재시도는 계속 남아 있고, 생략 기준은 비용 로그와 실패 이력에 한정됩니다.
버릴 글감은 큐에 넣기 전에 걸러냅니다
이 작업을 하면서 큐 처리 방식도 같이 고쳤습니다. 자동 제외될 글감을 워커가 잡은 뒤 “스킵”만 하고 끝내면 큐에는 이미 들어간 행이 남습니다. 그러면 상태가 애매해지고 재시도 경로가 꼬입니다.
자동 제외 대상은 처음부터 큐에 넣지 않게 했습니다. 비용 최적화라고 해도 결국 상태 전이가 깨끗해야 운영에서 믿을 수 있습니다.
4. 한 번을 싸게 만들어도 무제한 생성은 남았습니다
검색과 파싱 비용을 줄여도, 글감 후보를 끝없이 만들면 전체 비용은 다시 커집니다. 예전에는 월 발행 한도는 있었지만 글감 생성에는 상한이 없었습니다. 사용자가 계속 후보를 만들고 고르지 않으면, 발행은 늘지 않는데 후보 준비 비용만 쌓일 수 있었습니다.
세 번째 글감을 없앨 근거는 없었습니다
먼저 키워드당 글감을 세 개에서 두 개로 줄이는 안을 확인했습니다. 세 번째 글감의 품질이 낮다면 불필요한 생성을 줄일 수 있습니다. 그런데 순번별 수치는 그 판단을 뒷받침하지 않았습니다.
| 글감 순번 | 계획 실패율 | 발행률 |
|---|---|---|
| 첫 번째 | 8.2% | 32.8% |
| 두 번째 | 6.6% | 35.6% |
| 세 번째 | 8.4% | 33.0% |
세 번째 글감이 유독 나쁘지 않았습니다. 이 자료만으로 생성량을 줄일 이유는 없었습니다. 대신 월 생성 상한을 뒀습니다.
월 상한과 쿨다운은 서버에서 지킵니다
상한은 월 발행 한도 × 5로 잡았습니다. 8월 당시 측정에서 발행 1건당 생성 후보 수는 3.05개에서 3.36개 사이였습니다. 그래서 5배는 현재 사용량보다 여유가 있지만, 무제한 생성은 막는 값입니다.
상한을 걸 때도 중요한 건 비용 예약이었습니다. 큐에 넣기 전에 생성권을 예약하고, 큐 등록이 실패하면 돌려줍니다. 살아남은 행 수만 세면 중간 실패에서 장부가 틀어질 수 있습니다.
또 하나는 반복 요청이었습니다. 서버에 60초 쿨다운을 두고, 화면에는 남은 대기 시간을 보여줬습니다. 처리 순서는 다음과 같습니다.
- 쿨다운 확인: 빠른 재요청은 한도를 차감하기 전에 거절합니다.
- 월 한도 차감: 생성할 양만큼 먼저 예약합니다.
- 큐 등록: 등록에 실패하면 차감한 양을 돌려줍니다.
화면의 버튼만 잠그는 것으로는 여러 탭이나 직접 API 호출을 막을 수 없었습니다.
이 상한은 검색 캐시처럼 단일 호출 비용을 줄이는 장치는 아닙니다. 대신 “발행으로 이어질 가능성이 낮은 후보”가 무한정 비용을 만드는 것을 막습니다. 비용 최적화는 단가만의 문제가 아니라, 비용이 발생하는 입구를 어디에 둘지의 문제였습니다.
5. 서버 로그로 다시 계산했습니다
마지막으로 실제 서버 로그로 숫자를 맞췄습니다. 대상은 춘천 B의 m-wdot-worker-1 컨테이너입니다. 컨테이너 로그에서 2026년 9월 16일 18:48:01–18:49:59 KST에 완료된 topic 40817–40831, 총 15건을 고정 표본으로 잡았습니다.
검색과 본문 파싱이 연결된 15건만 셉니다
SERP와 research 단계는 검색어로 연결했고, research와 fulltext 단계는 topic ID로 연결했습니다. 검색과 본문 파싱이 모두 연결된 15건만 계산했습니다. 앞쪽에 고립된 SERP 1건은 어떤 글감의 research/fulltext와 연결되지 않아 제외했습니다.
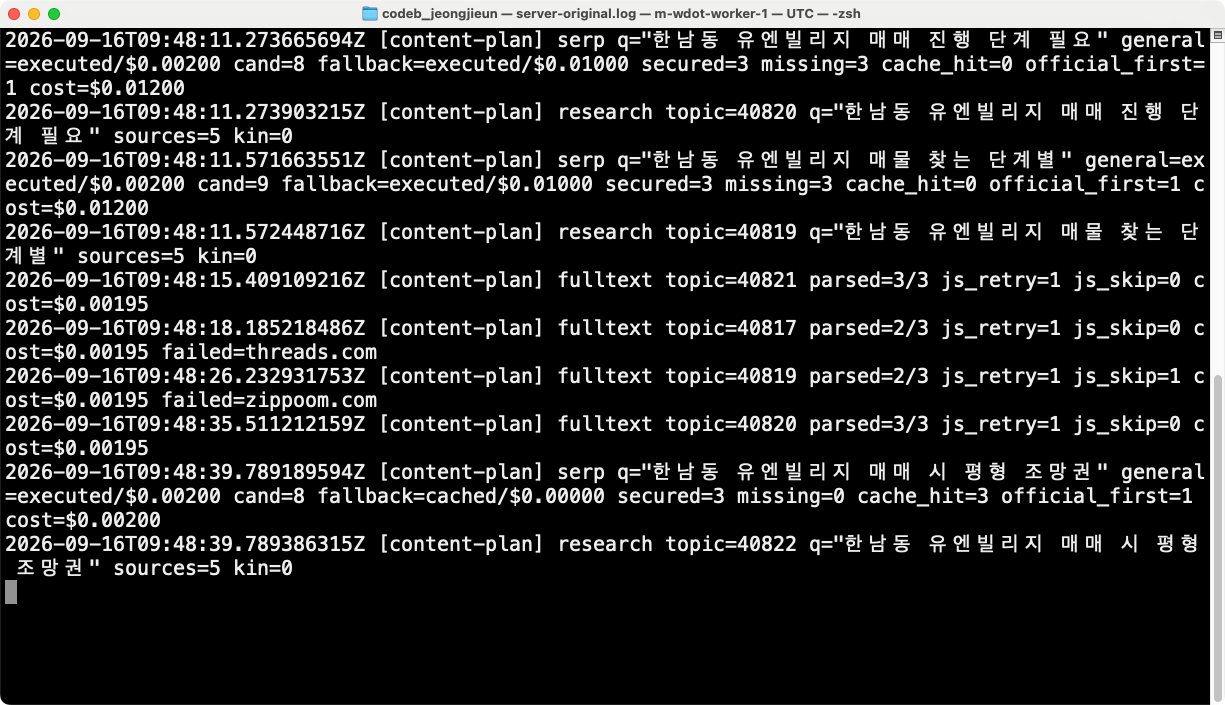
실제 비용과 생략 호출 환산액을 나란히 놓습니다
| 항목 | 로그상 실제 비용 | 생략 호출 환산액 | 생략하지 않았을 때 비교값 |
|---|---|---|---|
| SERP | $0.08200 | 10 × $0.010 = $0.10000 | $0.18200 |
| 본문 파싱 | $0.02490 | 9 × $0.0015 = $0.01350 | $0.03840 |
| 합계 | $0.10690 | $0.11350 | $0.22040 |
환율을 1,400원/$로 고정하면 실제 비용은 149.66원, 생략하지 않았을 때의 비교값은 308.56원입니다. 차이는 158.90원이고, 절감률은 0.11350 / 0.22040 = 51.5%입니다.
글감 하나로 나누면 비교값은 20.57원, 실제 비용은 9.98원입니다. 그래서 이 표본에서는 “글감 하나를 준비하는 검색·파싱 비용”이 약 20.6원에서 10.0원으로 내려간 셈입니다.
IMPORTANT
51.5%는 15건 단일 배치의 검색·본문 파싱 비용 기준입니다. LLM 구독료, 서버비, DB 비용, 발행 후 운영 비용은 들어 있지 않습니다.
최적화 전 코드를 같은 조건으로 다시 실행한 실험도 아닙니다. 실제 로그에서 생략된 호출 수를 세고, 같은 단가를 곱해 “생략하지 않았다면 냈을 비용”을 계산한 값입니다.
그래도 이 정도면 판단에는 충분했습니다. 큰 모델 호출을 줄인 것도 아니고, 서버를 바꾼 것도 아닙니다. 같은 검색을 다시 사지 않고, 반복 실패가 확인된 재시도를 건너뛰고, 발행과 무관한 후보 생성을 제한했습니다. 그 결과가 운영 로그에서 보였습니다.
다음에 줄일 곳도 보입니다.
- 동시에 들어온 중복 검색: 같은 키워드가 차가운 캐시를 함께 두드리면 첫 요청들이 같은 검색을 실행할 수 있습니다. 짧은 락이나 singleflight가 필요합니다.
- 선택 전 목차 준비: 모든 후보의 목차를 먼저 만들지 않고, 사용자가 고른 뒤에 깊게 준비하는 방향도 있습니다. 대신 선택 화면이 빈약해질 수 있어 UX와 비용을 같이 봐야 합니다.
이번에 얻은 가장 큰 교훈은 단순합니다. 비용은 “비싼 호출”에서만 새지 않았습니다. 싼 호출이 후보 수만큼 반복되고, 실패하는 재시도가 습관처럼 붙고, 선택되지 않을 작업까지 미리 준비할 때 새고 있었습니다. 그래서 먼저 로그를 나눠야 했고, 그다음에야 줄일 수 있었습니다.
마무리하며
이 글에서 확인한 것은 검색·본문 파싱 구간의 비용 구조입니다. 중복 검색, 반복 실패 재시도, 발행으로 이어지지 않는 후보 생성을 따로 나눠 보니 작은 호출도 충분히 줄일 대상이 됐습니다. 다만 51.5%라는 수치는 15건 단일 배치의 환산값이므로, 앞으로의 판단도 같은 방식으로 로그 범위와 비교 기준을 붙여 봐야 합니다.
댓글