[메신저 부하 테스트 2편] AI가 생성한 코드에 deadlock이 숨어 있었다 — `unreadCount`를 `lastReadAt`으로 교체한 이야기
부하 테스트 시작 9분 만에 HTTP 오류율 42.8%, 목표 TPS의 12%. 범인은 AI 보조 코딩 중 무심코 작성한 단 한 줄의 updateMany였습니다.
목차
- 들어가며
- 1 발견
“목표가 75 TPS인데 왜 9.5 TPS밖에 안 나오지?”
- 2 진짜 범인
40P01 deadlock detected
- 3 코드 점검
잠깐, 메시지 하나당 쓰기를 4~5번 한다고?
PG 로그에서 나온 직접적인 증거 - 4 코드 생성 뒤에 남은 동시성 검토 공백
- 5 테이블에 오른 처방들
어디까지 손대야 하는지
- 6 우리가 고른 것
- 7 마이그레이션
조회 전환, 일괄 쓰기 제거, 컬럼 정리
확인한 결과와 검증 목표를 구분합니다 - 마무리하며
들어가며
NOTE
부하 테스트 시작 9분 만에 HTTP 오류율 42.8%. 범인은 AI 보조 코딩 중 무심코 작성한 단 한 줄의 updateMany였습니다.
앞서 1편에서 세운 부하 테스트 환경으로, 이제 send API가 실제로 몇 TPS까지 버티는지 처음 측정할 차례였습니다. 목표는 채팅 전송 75 TPS — 그리 무리한 숫자도 아니었습니다. 그런데 테스트를 켜자마자 수치가 목표에서 크게 벗어났고, 이 글은 그 원인을 끝까지 파고든 기록입니다.
1. 발견 — “목표가 75 TPS인데 왜 9.5 TPS밖에 안 나오지?”
부하 테스트 환경에서 채팅 트래픽 75 TPS를 목표로 k6를 돌렸습니다. 돌아온 수치는 기대와 크게 달랐습니다.
| 지표 | 값 |
|---|---|
| 목표 TPS | 75 req/s |
| 달성 TPS | 9.5 req/s (목표의 12%) |
| HTTP 오류율 | 42.8% |
| HTTP 5xx | 4.07 req/s |
| Postgres 활성 커넥션 | 11 / 최대 27 — 여유 충분 |
| Centrifugo publish 실패 | 0 |
가장 먼저 의심할 대상은 언제나 connection pool 고갈입니다. 하지만 Postgres는 27개 커넥션 중 11개만 쓰고 있었고, Centrifugo publish는 100% 성공하고 있었습니다. 모든 신호가 앱 서버의 데이터베이스 쿼리 자체를 가리키고 있었습니다.
2. 진짜 범인 — 40P01 deadlock detected
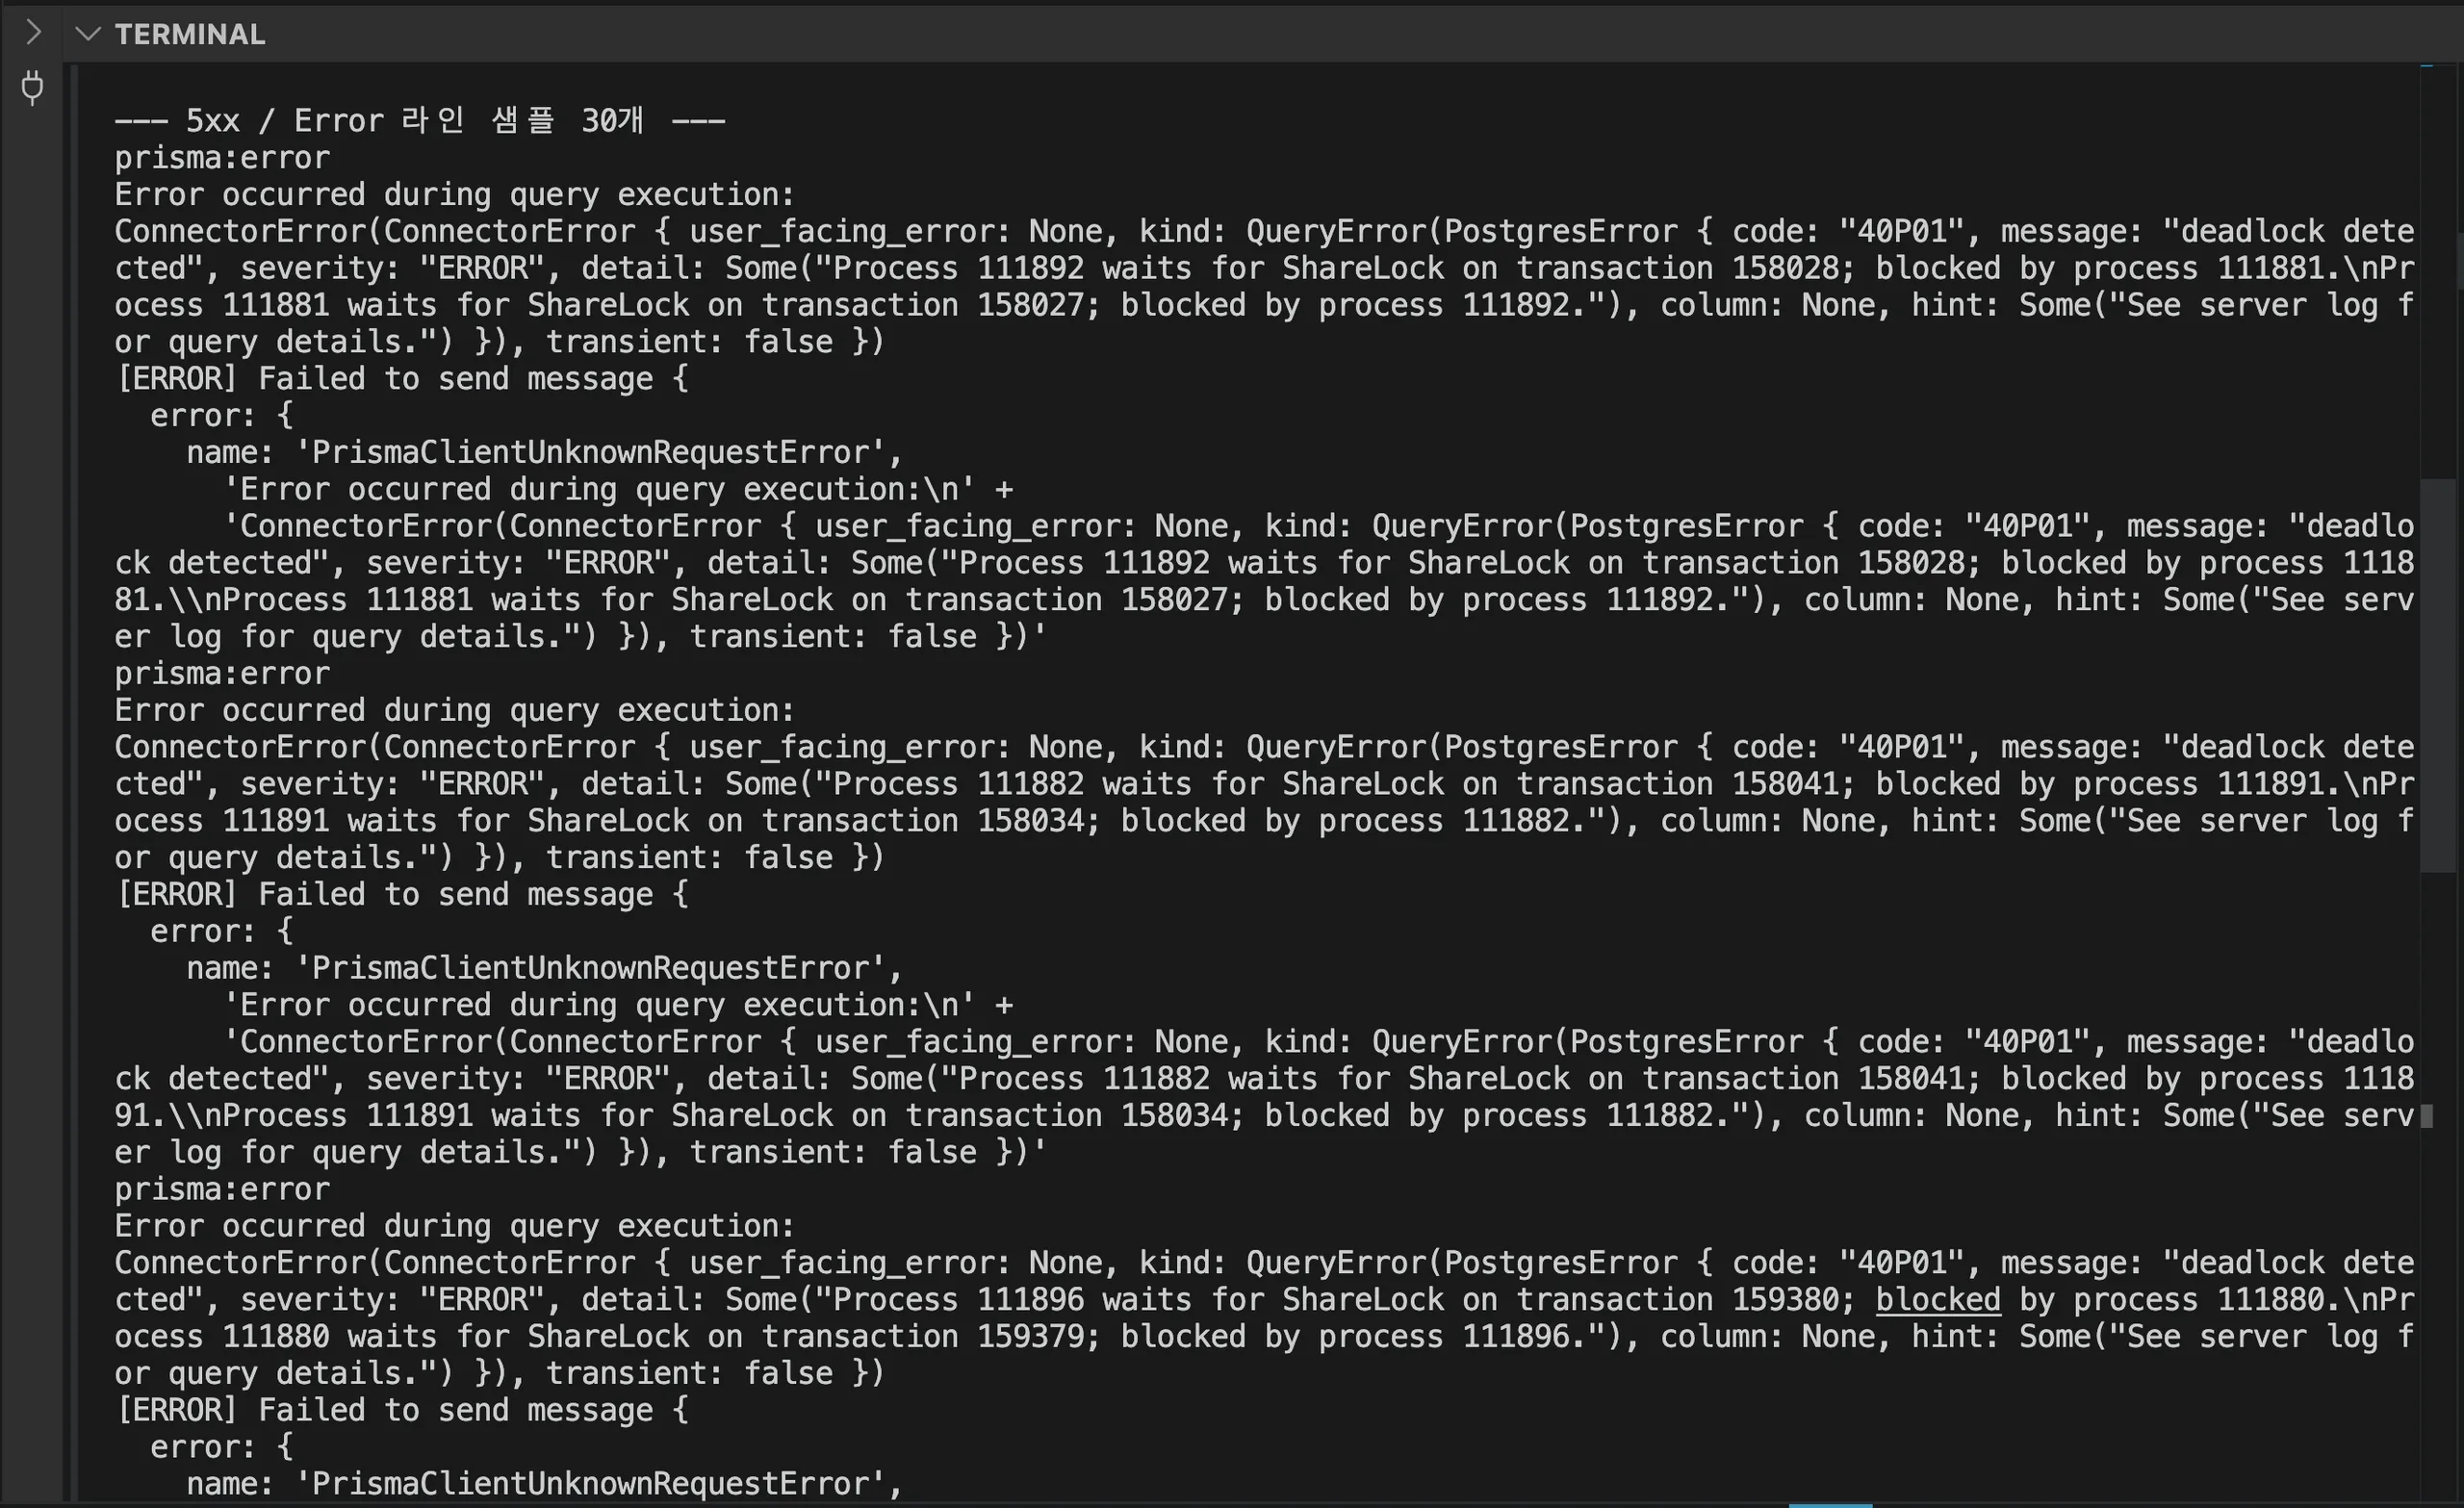
docker logs witim-web를 보니 5xx 라인이 전부 똑같은 모양이었습니다.
prisma:errorError occurred during query execution:ConnectorError(... QueryError(PostgresError { code: "40P01", message: "deadlock detected", severity: "ERROR", detail: Some("Process 111892 waits for ShareLock on transaction 158028; blocked by process 111881. Process 111881 waits for ShareLock on transaction 158027; blocked by process 111892.")}))P2024(pool timeout)도 아니고, ETIMEDOUT도 아니었습니다. 순수한 PostgreSQL row-lock deadlock. 열여섯 개의 동시 트랜잭션이 같은 행 집합을 서로 다른 순서로 잠그며 충돌하고 있었던 것입니다.
3. 코드 점검 — 잠깐, 메시지 하나당 쓰기를 4~5번 한다고?
문제의 핸들러인 POST /api/channels/[id]/messages는 트랜잭션 래퍼도 없이 4~5번의 순차 쓰기를 하고 있었습니다.
| # | 작업 | 락 영향 |
|---|---|---|
| 1 | message.create (Message + Mention + Attachment 중첩) | Channel/User row KEY SHARE |
| 2 | message.update (parent.replyCount++) [답글일 때만] | parent Message row exclusive |
| 3 | channel.update (updatedAt) | Channel row exclusive |
| 4 | channelMember.updateMany (다른 멤버들의 unreadCount++) | 여러 ChannelMember row exclusive ← deadlock 유발 지점 |
| 5 | channelMember.updateMany (보낸 사람 unreadCount=0) | 보낸 사람 ChannelMember row exclusive |
4번이 치명적입니다. 사용자 A와 B가 같은 채널에 동시에 메시지를 보내면 이런 일이 벌어집니다.
Tx-A: UPDATE ChannelMember WHERE channelId=X AND userId != A → locks rows B, C, D, ... one at a time, in scan orderTx-B: UPDATE ChannelMember WHERE channelId=X AND userId != B → locks rows A, C, D, ... one at a time, in scan orderupdateMany는 하나의 SQL 문이지만 여러 행을 갱신하며 각 행에 락을 획득합니다. 같은 채널을 대상으로 하더라도 송신자에 따라 갱신 대상은 달라집니다. 이 코드에는 여러 행의 락 획득 순서를 명시적으로 통일하는 장치가 없었습니다.
PG 로그에서 나온 직접적인 증거
deadlock마다 CONTEXT 라인이 매번 달랐습니다.
| 시각 | CONTEXT |
|---|---|
| 05:28:46 | while updating tuple (44,45) |
| 05:28:54 | while updating tuple (105,19) |
| 05:28:55 | while updating tuple (89,28) |
| 05:29:09 | while locking tuple (214,56) |
| 05:29:10 | while locking tuple (1364,5) |
(page, slot)은 충돌한 행의 물리적 위치입니다. 이 값이 다르다는 사실만으로 각 트랜잭션의 전체 락 획득 순서를 입증할 수는 없습니다. 관련 이슈에서 추가로 추출한 STATEMENT에는 서로 기다리는 두 프로세스가 모두 ChannelMember.unreadCount를 일괄 증가시키는 UPDATE를 실행하고 있었습니다. 순환 대기 로그와 실행 SQL을 함께 보고 문제의 카운터 갱신 경로를 확인했습니다.
4. 코드 생성 뒤에 남은 동시성 검토 공백
솔직히 털어놓겠습니다. 이 updateMany는 AI 보조 코딩 중에 생성된 코드입니다.
// Intent: "When a message is sent, bump unreadCount by 1 for every other member"await prisma.channelMember.updateMany({ where: { channelId, userId: { not: senderId } }, data: { unreadCount: { increment: 1 } },});문법적으로는 완벽합니다. 단일 채널, 단일 메시지, 단일 사용자 테스트에서는 흠잡을 데 없이 동작합니다. PR 리뷰도 통과했습니다.
하지만 이 코드는 반드시 던졌어야 할 두 가지 질문을 조용히 건너뛰었습니다.
-
“메시지 하나가 올 때마다 정말로 N개의 행에 쓰기를 해야 하는지” — 멤버가 200명인 채널이라면 메시지 하나당 200번의 행 쓰기가 발생합니다. 100명의 사용자가 메시지를 보내면 초당 20,000번의 쓰기입니다. 이 규모에서 메시지마다 RDBMS 행 쓰기를 하는 것은 구조적으로 비효율적입니다.
-
“두 사람이 같은 채널에 동시에 글을 올리면 어떻게 되는지” — 이것이야말로 모든 메시징 앱의 핵심 사용 패턴입니다. AI는 이 점을 고려하지 않았습니다. 그리고 PR을 머지한 저 역시 마찬가지였습니다.
이것이 AI 코딩의 함정입니다. 동작하는 것처럼 보이는 코드는 동시성 시나리오에 대한 고민을 건너뛰게 만듭니다. 부하 테스트가 없었다면 이 문제는 프로덕션에서 똑같이 터졌을 것입니다.
5. 테이블에 오른 처방들 — 어디까지 손대야 하는지
이슈에는 세 단계의 수정안이 올라왔습니다.
P0 (즉시):
-
40P01에 대한 deadlock 재시도 인터셉터 -
updateMany를ORDER BY id FOR UPDATE가 포함된 raw SQL로 다시 작성 → 결정적(deterministic) 락 순서
P1 (단기):
unreadCount를 Redis HINCRBY로 옮기고 주기적으로 DB에 플러시
P2 (중기):
channelId해시로 Message INSERT를 파티셔닝
P0는 재시도로 실패를 완화하거나 락 획득 순서를 맞추는 접근입니다. 하지만 메시지 1개 = 멤버 수에 비례하는 행 쓰기라는 구조는 그대로 남습니다. 그래서 카운터를 일괄 갱신하는 작업 자체를 없애는 방향을 검토했습니다.
P1(Redis)은 더 빠르지만 Redis ↔ Postgres 동기화 복잡도를 끌어들입니다. unreadCount가 Postgres와 일시적으로 어긋나고, Redis 플러시가 실패하면 카운트가 영구적으로 틀어질 수 있습니다.
그래서 우리는 다른 방향을 선택했습니다.
6. 우리가 고른 것 — 읽은 시점 기준으로 미읽음 수 계산하기
핵심은 사용자마다 어디까지 읽었는지를 저장하고, 그 이후의 메시지 수를 조회할 때 계산하는 것입니다. 메시지가 올 때마다 다른 멤버들의 unreadCount를 증가시키는 방식에서, ChannelMember.lastReadAt과 Message.createdAt을 비교하는 방식으로 전환했습니다.
여기서 DB 컬럼과 API 응답을 구분해야 합니다. 폐기 대상은 DB에 저장해 두고 계속 증감하던 ChannelMember.unreadCount입니다. 클라이언트가 받는 API 응답의 unreadCount 필드는 유지하고, 그 값을 조회 시 계산한 미읽음 수로 채웠습니다.
읽은 메시지의 시점을 기록합니다
lastReadAt은 일자 단위의 값이 아니라 타임스탬프입니다. 특정 메시지까지 읽었다는 요청이 오면 해당 메시지가 그 채널에 속하는지 확인하고, 그 메시지의 createdAt을 읽음 기준으로 삼습니다. 전체 읽음 요청에서는 채널의 최신 메시지를 찾아 기준 시점과 lastReadMessageId를 함께 갱신하도록 보완했습니다.
lastReadMessageId는 화면의 읽음 구분선 위치에도 쓰입니다. 따라서 숫자만 0으로 만드는 것과 읽음 위치를 이동하는 것은 함께 처리해야 했습니다. 늦게 도착한 요청이 읽음 시점을 과거로 되돌리지 않도록, 갱신에는 GREATEST를 사용하고 미래 시각을 제한하는 방어도 뒀습니다.
다음은 미읽음 계산의 핵심 조건만 나타낸 개념식입니다.
미읽음 수 = 해당 채널에서 삭제되지 않았고, Message.createdAt > ChannelMember.lastReadAt이며, 사용자별 미읽음 집계 정책에 해당하는 메시지 수실제 조회에는 삭제 여부와 답글·멘션 정책도 반영됩니다. 답글 집계 정책은 후속 작업에서 조정됐지만, 읽음 시점을 기준으로 계산하고 다른 멤버들의 카운터를 일괄 갱신하지 않는 원칙은 유지됐습니다.
이전 — 메시지마다 다른 멤버의 카운터 갱신
[메시지 전송]  ├─ Message 저장  ├─ 다른 멤버들의 unreadCount 증가  ← 여러 행에 쓰기·락 발생  └─ 보낸 사람의 읽음 상태 갱신
[메시지 삭제]  └─ 다른 멤버들의 unreadCount 감소
이후 — 읽음 위치 저장과 미읽음 조회 분리
[메시지 전송]  ├─ Message 저장  ├─ 보낸 사람의 읽음 위치 갱신  └─ 다른 멤버들의 unreadCount 증가 없음
[채널 목록 조회]  └─ lastReadAt 이후의 집계 대상 메시지를 COUNT       → API 응답의 unreadCount로 반환
[메시지 읽음 처리]  └─ 해당 사용자의 lastReadAt과 lastReadMessageId 갱신
[메시지 삭제]  └─ 삭제 상태 반영 → 다음 COUNT에서 제외       (멤버별 unreadCount 감소 없음)
위 도식은 미읽음 처리와 관련된 작업만 나타냅니다. 메시지 전송의 모든 DB 작업이 INSERT 한 번으로 줄었다는 뜻은 아닙니다. 보낸 사람의 읽음 위치 갱신과 답글 수 갱신 등은 별도로 남습니다.
어떤 데드락 경로를 제거했는가
메시지 전송·삭제 시 여러 멤버의 unreadCount를 증감하던 updateMany를 제거했습니다. 이 변경으로 이번 장애에서 확인한 여러 멤버 행을 함께 잠그는 카운터 갱신 경로가 사라졌습니다.
읽음 처리는 해당 사용자의 멤버십 행을 갱신합니다. 다만 같은 사용자가 여러 기기에서 동시에 읽음 요청을 보낼 수 있으므로, 모든 락 경합이 없어지는 것은 아닙니다. 이번 수정의 범위는 미읽음 카운터의 일괄 쓰기에서 발생한 데드락 원인을 제거하는 것입니다.
쓰기 비용을 줄인 대신 조회 비용을 확인합니다
기존에는 메시지 하나가 들어올 때마다 멤버 수에 비례하는 카운터 쓰기가 발생했습니다. 전환 후에는 채널 목록 조회 시 미읽음 수를 계산하는 비용을 부담합니다.
Phase 1 구현은 채널마다 쿼리를 하나씩 보내지 않고, 사용자가 속한 채널들의 미읽음 수를 배치 쿼리로 계산했습니다. (channelId, isDeleted, createdAt) 인덱스를 활용하도록 구성했습니다. 다만 인덱스가 있다고 COUNT 비용이 없어지는 것은 아니므로, 조회 지연과 동시 부하도 함께 확인해야 합니다.
7. 마이그레이션 — 조회 전환, 일괄 쓰기 제거, 컬럼 정리
최종 방향은 unreadCount 쓰기를 유지하는 것이 아니라 읽음 시점 기준 계산으로 전환하고 기존 카운터를 제거하는 것이었습니다. 실제 작업은 조회 전환과 쓰기 제거를 나눠 진행했습니다.
| 단계 | 변경 내용 | 기존 카운터 쓰기와 데드락의 관계 |
|---|---|---|
| Phase 1 — 조회 전환 | lastReadAt 추가·기존 읽음 위치 보정, API의 unreadCount를 계산값으로 전환 | 비교 검증을 위해 기존 쓰기를 잠시 유지했습니다. 이 단계만으로 데드락 원인은 없어지지 않습니다. |
| Phase 2 — 일괄 쓰기 제거 | 메시지 전송 시 증가 함수와 호출, 삭제 시 감소 쿼리 제거 | 문제가 된 여러 멤버 행의 카운터 증감 경로를 제거했습니다. |
| Phase 3 — 잔여 참조·컬럼 정리 | 대시보드 집계 등 남은 참조를 계산 방식으로 바꾸고 DB 컬럼 제거 | 원인 쿼리를 제거한 뒤 수행하는 스키마 정리입니다. API 응답 필드는 유지합니다. |
Phase 1은 2026년 5월 8일 머지된 PR #836에 해당합니다. 당시에는 조회 결과를 새 방식으로 바꾸면서 기존 카운터와의 차이를 확인하기 위해 쓰기를 잠시 남겨뒀습니다. 이 과도기를 최종 설계와 혼동하면 안 됩니다.
Phase 2는 2026년 5월 20일 머지된 PR #974에 해당합니다. updateUnreadCounts() 함수와 메시지 전송 시 호출을 없애고, 메시지 삭제 시 unreadCount를 감소시키던 updateMany도 제거했습니다. 이번 데드락의 원인 경로가 사라지는 시점은 조회 결과를 바꾼 때가 아니라, 이 일괄 쓰기를 제거한 때입니다.
컬럼 삭제는 별도 단계였습니다. Phase 2 이후에도 대시보드 집계와 읽음 처리 등에 기존 컬럼 참조가 남아 있었기 때문에, 이를 정리한 뒤 컬럼을 제거하도록 나눴습니다. 이슈의 마지막 기록에는 운영 DB 반영과 main 배포 완료가 남아 있습니다.
확인한 결과와 검증 목표를 구분합니다
PR #974에는 staging 부하 테스트에서 PostgreSQL 로그의 40P01 카운트가 0임을 확인했다는 기록이 있습니다. 반면 75 TPS 회복과 HTTP 오류율 1% 미만은 검증 목표로 기재돼 있고, 해당 PR에서 완료된 측정값은 확인하지 못했습니다. 따라서 이 글에서는 두 수치를 달성한 성과로 쓰지 않습니다.
NOTE
2026년 10월 18일 수정: 관련 이슈와 머지된 PR을 대조해 읽음 시점 기반 계산과 실제 전환 단계를 정리했습니다. 초판의 “읽기 API만 전환하면 데드락 유발 지점이 사라진다”는 설명을 바로잡고, 초판 발행일 이후의 쓰기 제거 작업을 반영했습니다.
마무리하며
이번 사건은 한 줄짜리 버그가 아니었습니다. 사고 패턴의 함정이었습니다.
-
AI가 생성한
updateMany는 “이걸 Prisma 문법으로 어떻게 표현하지?” 라는 질문에 대한 정답입니다. -
하지만 _“메시징 앱에서 두 사용자가 같은 채널에 동시에 글을 올릴 때, 이 SQL은 어떻게 락을 획득하는지”_라는 질문에 대한 답은 아닙니다. 아무도 그 질문을 하지 않았기 때문입니다.
-
AI가 생성한 코드가 빠르게 안착할수록, 동시성, 격리성, 확장성에 대한 사람의 리뷰가 더 중요해집니다. 그것이 바로 PR 리뷰의 진짜 가치입니다.
한 가지 교훈이 더 있습니다. 부하 테스트는 프로덕션 이후가 아니라 이전에 해야 합니다. 격리된 부하 테스트 환경이 없었다면 이 문제는 100K CCU 트래픽 아래에서 터졌을 것입니다. 저희는 프로덕션에서 deadlock 사이클이 일으키는 5xx 오류를 대응하고 있었을 것입니다. 그 환경 자체가 하나의 장애를 막아준 셈입니다.
👈 1편: “메신저 서비스를 위한 재사용 가능한 부하 테스트 환경 구축 — Make 기반 IaC, Observability, 그리고 Auth Seeding”
댓글